背景
- 2026-03 發起,團隊目前 3 人;我是發起人與主要維護者,負責整體架構、評測系統與 production release。
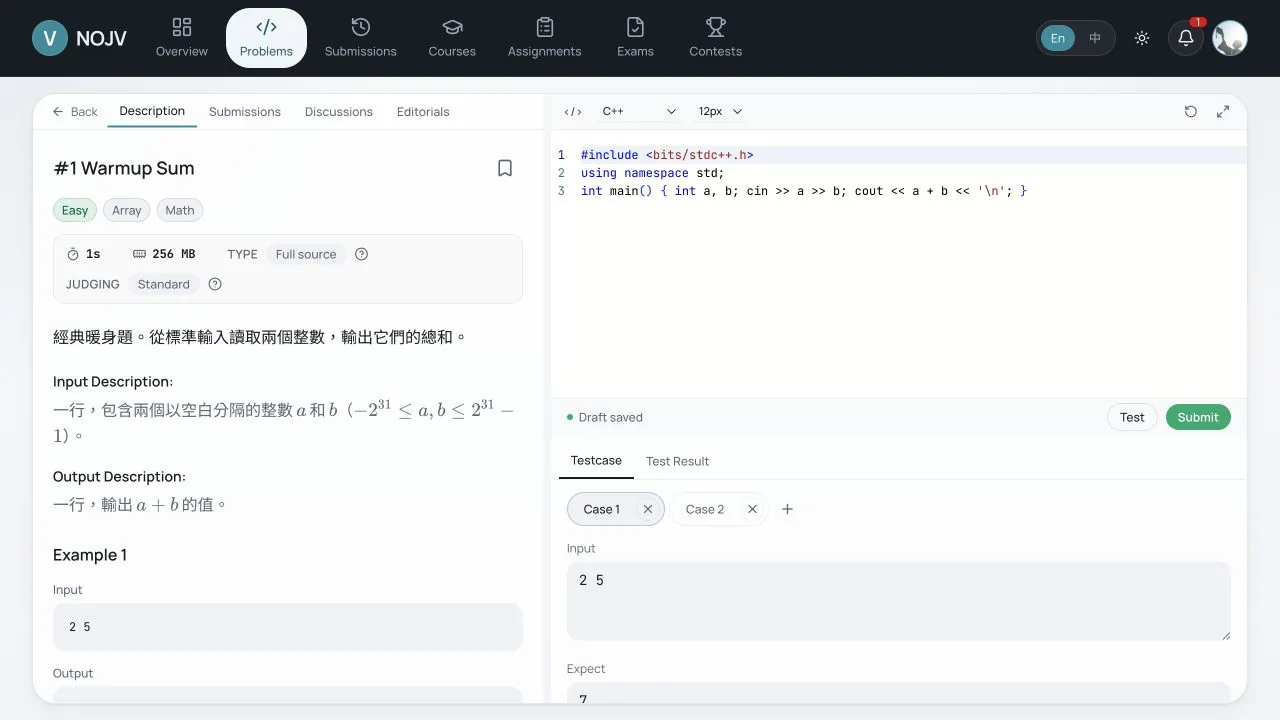
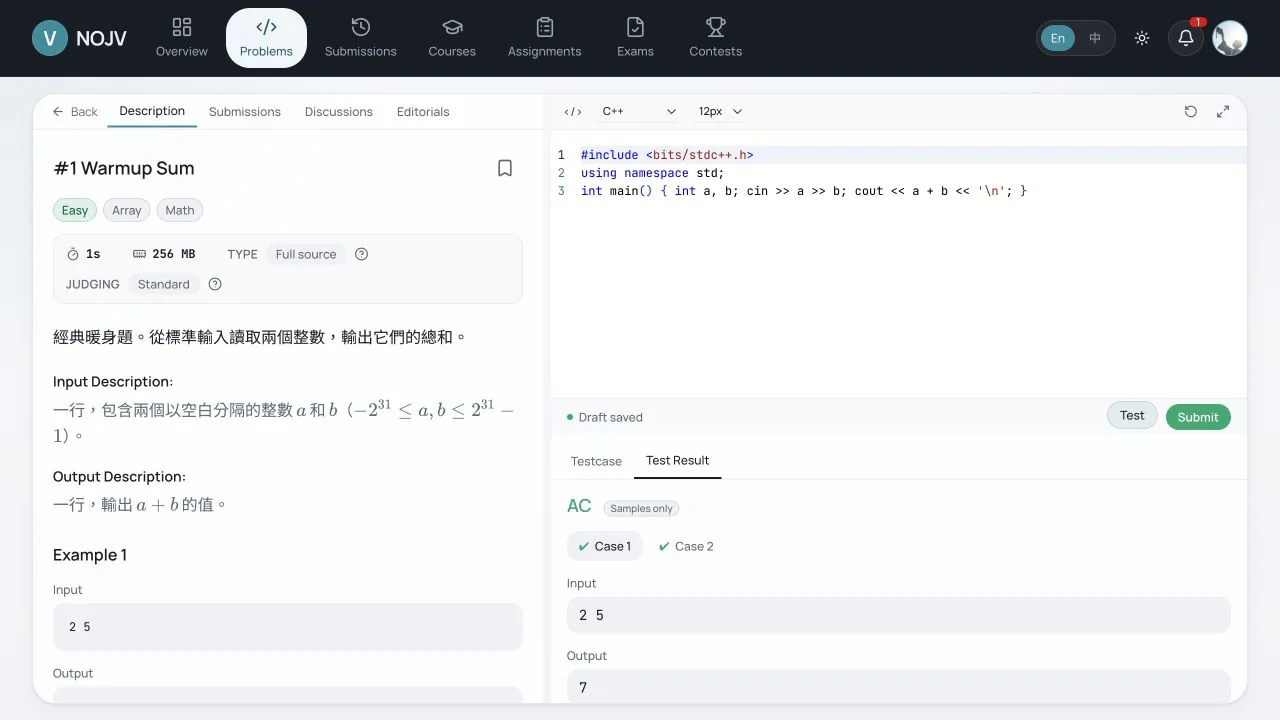
- 支援 C、C++、Go、Java、JavaScript、Python、Rust、TypeScript 八種語言,以及 Standard、Checker、Interactive 三種評測方式;提供 ICPC/IOI scoring、即時 scoreboard、freeze、課程作業期限與 Dolos AST 程式相似度檢測。
- 流程:提交寫入 PostgreSQL 與物件儲存後,由 Temporal workflow 派送給 judge worker;每個評測 stage 在 gVisor sandbox 中執行,判決經 Redis 以 SSE 推回瀏覽器,SSE 中斷時前端改以輪詢補上,不會漏掉結果。
評測排程:用 Temporal 原生優先權取代自製協調器
- 問題:一次重新評測 789 筆提交時,每筆排隊中的 workflow 都在輪詢自製的容量協調器;worker 忙著重播歷史事件,佇列積壓約 700 個任務、長達 16 分鐘,學生即時送出的提交被卡在重新評測後面。
- 做法:改用 Temporal 原生的 priorityKey 與 fairnessKey,讓考試優先於競賽,再優先於練習、復原與重新評測,並限制每位學生同時只有一筆提交在評測;容量直接由 worker slot 決定,Kubernetes ResourceQuota 作為硬性上限,整個自製協調器因此刪除。評估過 Kueue 與 HPA/KEDA,但在單節點叢集上不划算。
- 結果:壓力測試中 100 筆提交在 243 秒內全數 AC;逐一刪除 Temporal 的 4 種元件 pod 後,32 筆提交仍全數 AC,沒有遺失任何工作。
Sandbox:準確量測時間與記憶體
- 問題:原本以整個容器的 cgroup CPU 計時,把 runner 自己的開銷算進學生程式,空程式量到 30–60 ms;gVisor 又沒有 memory.peak,記憶體超限可能讓整個容器被 OOM。
- 做法:自寫約 170 行 C 的 nojv-exec,以 rlimit 限制資源、以 wait4 取得 CPU 時間與 peak RSS,wall clock 只作為看門狗;並改成每個 stage 一個 Pod,prepare、run、judge 各一個容器,標準答案只存在 judge 容器。評估過 Firecracker/Kata 等更重的隔離方案,最後維持 gVisor,把工夫放在量測本身。
- 結果:空程式的量測降到 0.98 ms;記憶體超限的 smoke test 從約 1/3 失敗變成 6/6 通過。之後再以 seccomp 限制 IPC,並在每筆測資前後清空暫存區,堵住同一 stage 內測資之間的狀態洩漏。
Release 與可靠性
- 以 tag 觸發建置,映像附 attestation 並以 digest 寫入 deploy 分支,由 Flux 部署到 Kubernetes,再由外部 status 服務驗證 release、livez 與 readyz。
- sandbox 清理改以 UID 前提條件刪除,無法確認時標為待清理並持久重試;修正 Kubernetes client 每次呼叫都重新建立 TLS 連線的問題後,清理延遲 p50 從約 541 ms 降到 121 ms。
- 建立 reference solution validation,在合併前實際驗證題目、答案與執行環境變更。
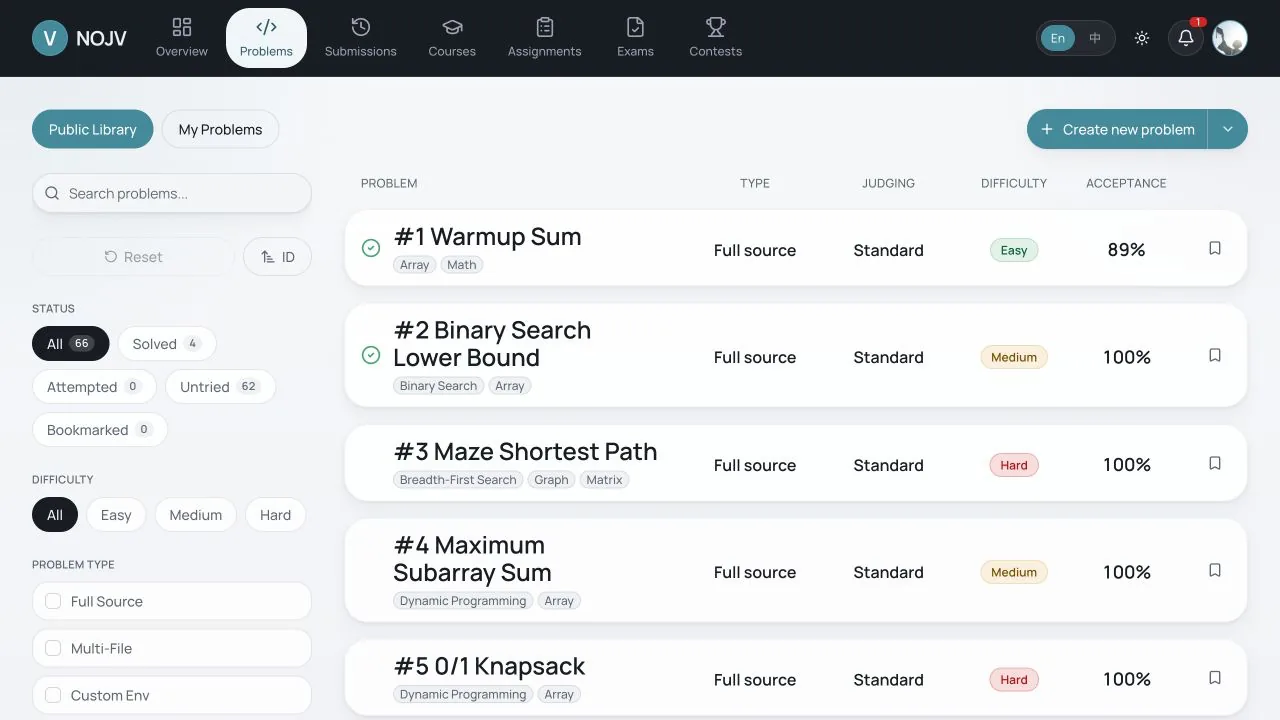
畫面來源說明:登入後的題庫與 Monaco Editor 實際產品畫面。