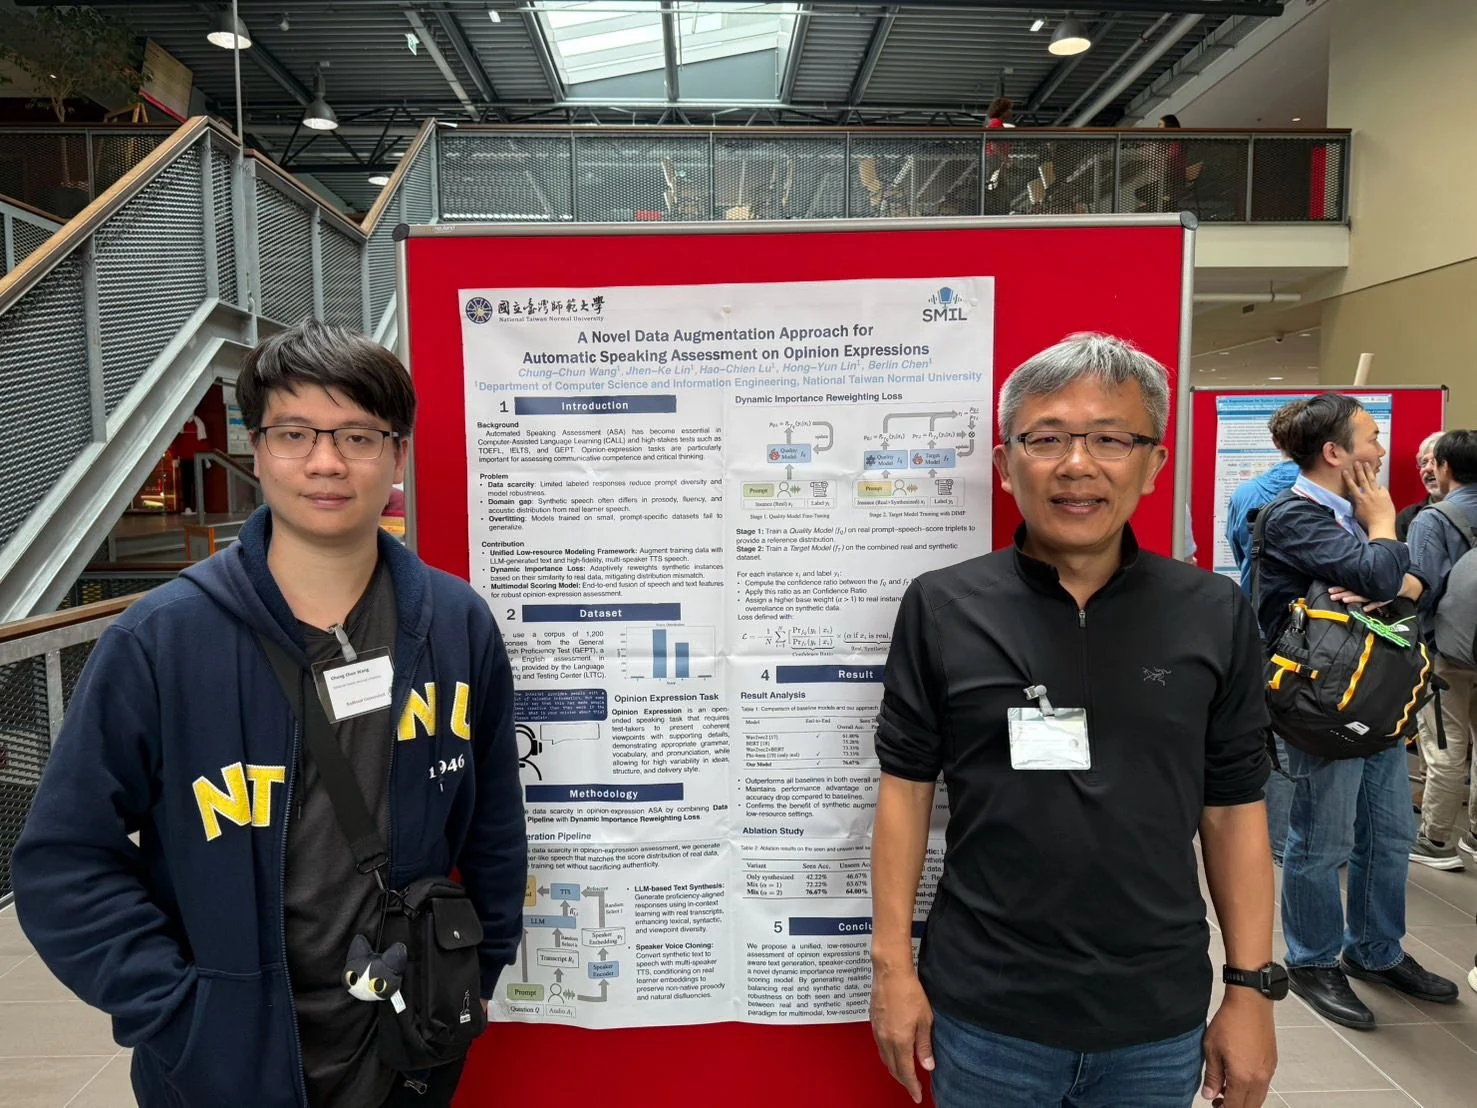
- 發表:10th Workshop on Speech and Language Technology in Education (SLaTE 2025), pp. 199–203
- 我的角色:第一作者。
- 問題:觀點陳述題的口說評量缺乏標註錄音,題目多樣性不足,評分的可靠度也因此受限。
- 方法:以 LLM 產生指定能力等級的多樣回答,透過 speaker-aware TTS 合成語音,並以 dynamic importance loss 依合成與真實語音的特徵分布差異調整訓練樣本權重;再由多模態 LLM 結合文字與語音特徵直接預測能力分數。
- 結果:在 LTTC 資料集上優於只用真實資料或傳統資料增強的方法,緩解了低資源限制。